|
|
|
|
|
英特尔团队 SparseDroop:面向 DNN 加速器电压跌落缓解的软硬件协同设计 | MDPI JLPEA |
|
|
论文标题:SparseDroop: Hardware–Software Co-Design for Mitigating Voltage Droop in DNN Accelerators
论文链接:https://www.mdpi.com/2079-9268/16/1/2
期刊名:Journal of Low Power Electronics and Applications
期刊主页:https://www.mdpi.com/journal/jlpea
一、引言
深度神经网络(DNN)加速器依赖大规模乘加(MAC)阵列的并行计算来实现高吞吐量。然而,成千上万个MAC单元同步开关会产生剧烈的瞬时电流尖峰(ICCmax),导致供电网络上的电压(VDD)发生跌落——这会压缩时序裕量、触发降频保护,甚至导致计算错误。传统应对方案(如预留电压余量、动态调频调压)要么引入额外功耗开销,要么在跌落发生后被动补救,且均将工作负载视为“黑盒”,忽略了DNN计算中固有的权重与激活稀疏性,难以从根源上兼顾性能与稳定性。
近日,来自英特尔公司的Arnab Raha研究员及其团队聚焦深度神经网络(DNN)加速芯片的供电稳定性课题,在JLPEA期刊上发表了一篇文章。该团队针对ASIC类 的DNN加速器的电压跌落问题,提出了一个硬件感知型的统一框架-- SparseDroop。它的核心思路是通过软硬件协同设计,利用DNN计算中固有的权重/激活稀疏性,主动管理瞬时电流分布,从而在不牺牲吞吐量和模型精度的前提下提升供电稳定性。SparseDroop由两项互补技术组成:SparseStagg和SparseBlock,由SparseStagger利用现成零值来错峰,SparseBlock通过布局来防止功耗尖峰。为验证上述协同机制的有效性,团队分别评估了调度层的峰值电流削减能力与剪枝层的精度保持能力。实验结果表明,SparseDroop在超过60%的计算回合中实现了53%–73%的峰值同时电流削减,在25%块剪枝比例下模型精度损失低于1%,且硬件开销极小。两者联手构成了一套可扩展、低开销的解决方案——既能稳住电压、提升能效和鲁棒性,又能无缝接入现有加速器流水线,只需少量微调就能保住模型的精度。该项研究对于保障DNN加速器的供电稳定性、指导低开销架构设计以及推动高能效AI芯片的工程落地具有重要意义。
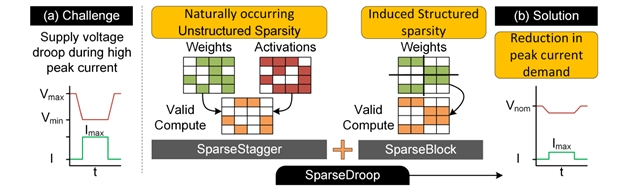
图1 SparseDroop概述
二、研究过程与结果
本研究首先分析了DNN加速器的核心架构特征——以二维PE阵列为计算核心,按列层次化组织,每个PE沿输入通道(IC)维度执行MAC累加,总计算延迟由负载最重的PE决定。该团队进一步指出现有稀疏性加速机制(通过位图标记非零值、跳过零值MAC)虽能提升能效,但仅作用于计算加速层面,并未被用于主动管理电流分布,无法解决同步启动导致的瞬时电流集中与电压跌落问题。
基于上述分析,该团队论证了IC-OC块级稀疏性作为解决路径的合理性——权重和激活值在PE间遵循可预测的结构化分布(IC顺序处理、OC分布在各列),以块级别(而非单个权重粒度)引入稀疏性可整块跳过计算与内存读取,其效率远优于细粒度剪枝。由此,该团队提出SparseBlock的设计思路:以IC-OC块级别诱导稀疏性并辅以微调,使稀疏性与硬件数据流对齐,同时降低同一列中PE同时激活的概率,为后续SparseStagger错峰调度器的设计奠定理论基础。
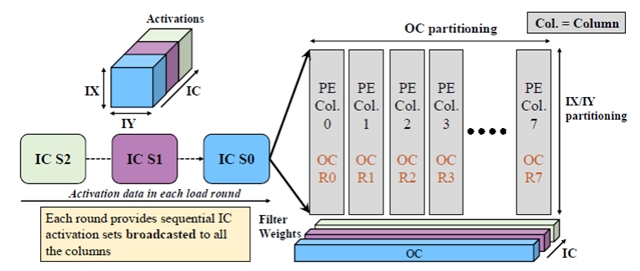
图2 分块执行模型,其中 IC 集合被依次广播至所有 PE 列,每一列负责处理一个独立的 OC 块
在完成问题建模与设计空间论证后,该团队具体阐述了SparseDroop框架的两项核心技术的实现机制。
SparseStagger调度器方面,该团队设计了一种基于下计数器(down-counter)的列级PE调度机制。在每个计算周期开始前,调度器接收各PE的PopCount(有效MAC操作数),识别出最大值作为时间基准,并初始化一个与该最大值相等的下计数器,每个时钟周期递减一次。当计数值与某PE的PopCount匹配时,该PE被使能启动——从而确保负载最重的PE立即开工,其余PE按负载从重到轻依次错峰启动,最终所有PE同时完成计算。研究强调,此机制仅依靠现有稀疏性位图获取PopCount信息,不引入额外稀疏化,不改变数据流,且所有PE与最慢者同步收工,实现了无损吞吐的电流平滑。调度器以列为粒度独立运行,无需跨列协调,具备良好的可扩展性。
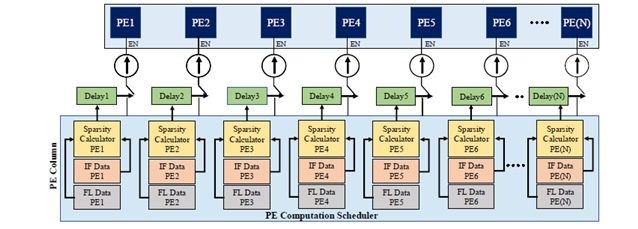
图3 PE 计算调度器的框图
SparseBlock剪枝方法方面,该团队在模型部署前引入与硬件数据流对齐的块级结构化稀疏。具体地,将权重张量沿输入通道维度划分为以8个通道为一组的IC8块,每个块作为原子单位——整块保留或整块剪枝。剪枝依据为各块的L2范数,范数最低的块被优先剪除,剪枝比例R均匀施加于每个输出通道以确保负载均衡。剪枝后,该团队通过少量轮次(3个epoch)的微调恢复精度,避免了从头训练的巨大开销。该方法使稀疏性与加速器访存粒度(IC8)完全对齐,不仅实现了计算与内存带宽的线性节省,更主动塑造了PE间负载差异,为SparseStagger创造了更大的错峰调度空间。
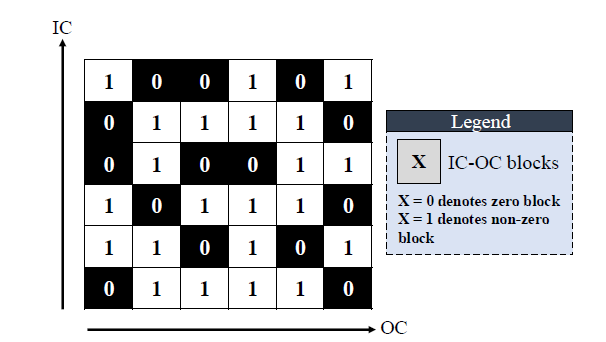
图4 R = 1/4 时的典型 SparseBlock 稀疏模式
在完成SparseStagger调度器与SparseBlock剪枝方法的设计后,该团队对两项技术分别进行了实验验证,评估其峰值电流削减能力与精度保持效果。
SparseStagger评估方面,该团队基于自建的周期精确架构仿真器,设置了16个PE、多种稀疏度组合(随机稀疏、25%/50%/75%密度)的实验场景,生成了100万组稀疏种子进行大规模仿真。实验结果显示:在不同稀疏度条件下,下计数PE调度器所实现的同步电流需求归一化降低率分布。对于随机稀疏度,超过一半的计算周期实现了53%至63%的降低。当权重和激活值均具有25%密度时,大多数周期落在39%至52%或52%至65%的范围内。当权重和激活值均保持50%平衡密度时,62.6%的周期实现了61%至73%的降低。即使在稀疏度为75%的低稀疏度情况下,仍有64.9%的周期将峰值同步活动降低了59%至69%。这些结果表明,SparseStagger能够持续平滑峰值电流需求,同时不影响吞吐量,在多种稀疏度场景下均能有效缓解VDD下降问题。
SparseBlock评估方面,该团队在ImageNet分类任务上对ResNet50v1.5、ResNet101、VGG16和Inception v1四种模型进行了验证。实验结果表明:对于ResNet50/101和VGG16,即使在R=4/16(即剪掉25%的IC8块)时,精度下降仍低于1%;Inception v1对剪枝更为敏感,但在R=2/16以下仍能保持小于1%的精度损失。从硬件效率角度看,剪枝IC8-OC块直接转化为计算与内存活动的等比例削减,例如R=1/4即可带来25%的DMA读取和MAC运算减少,且避免了非结构化剪枝的不规则访存问题。研究进一步指出,所有网络的精度损失与所获得的计算/内存节省呈反比关系,证实了SparseBlock在精度可接受范围内提供了线性效率增益,且与加速器数据流完美对齐。
三、研究总结及未来展望
本研究提出了SparseDroop框架,包含两个核心组件:SparseStagger——一个利用工作负载稀疏性缓解VDD跌落且不影响吞吐量的轻量级调度器;以及SparseBlock——一种与架构对齐的稀疏性方法,在减少计算和内存需求的同时保持精度。实验结果表明,SparseStagger在不同稀疏度场景下持续降低峰值同时电流需求,而SparseBlock在低实用剪枝比例下实现了<1%的精度损失,并提供线性效率增益。两者结合,SparseDroop证明了稀疏性既可以作为计算优化手段,也可以作为供电稳定性的系统级机制。该框架已在Intel下一代NPU芯片FlexNPU-v2上获得相关性验证,且硬件开销极低(仅计数器+比较器+FSM),不改变数据流与流水线,验证了其工程落地可行性。
最后,该团队提出以下三个扩展方向:其一,将SparseDroop扩展至Transformer类模型,这类网络中的激 活稀疏性模式与卷积网络不同且可预测性较低,需进一步适配;其二,探索与动态电压频率调整(DVFS)的协同优化,实现工作负载均衡与供电裕量的全局最优;其三,将SparseStagger的调度机制推广至其他具有列式PE层次的加速器架构,SparseBlock的块粒度也可根据具体硬件内存布局重新定义,具备良好的可移植性。
Raha, A.; Kundu, S.; Das, A.; Ghosh, S.K.; Mathaikutty, D.A. SparseDroop: Hardware–Software Co-Design for Mitigating Voltage Droop in DNN Accelerators. J. Low Power Electron. Appl. 2026, 16, 2.
期刊介绍
主编:Davide Bertozzi, University of Manchester, UK
Journal of Low Power Electronics and Applications (IF 1.7, ISSN 2079-9268)是一个国际性、经过严格同行评审的开放获取学术期刊。期刊旨在发表低功耗电子方向的创新研究和重要成果。期刊范围涵盖的主题包括但不限于新兴电子器件和工艺技术、模拟、数字和混合信号VLSI电路、架构和系统设计、SoC和嵌入式系统、能量采集和无电池系统、综合和优化工具,以及用于低功耗设计的CAD工具和方法。目前被Scopus、ESCI (Web of Science) 等数据库收录。
2025 Impact Factor:1.7
2025 CiteScore:4.6
Time to First Decision:21.8 Days
Acceptance to Publication:4.8 Days
特别声明:本文转载仅仅是出于传播信息的需要,并不意味着代表本网站观点或证实其内容的真实性;如其他媒体、网站或个人从本网站转载使用,须保留本网站注明的“来源”,并自负版权等法律责任;作者如果不希望被转载或者联系转载稿费等事宜,请与我们接洽。