|
|
|
|
|
FCS 中国科学院计算所阚美娜等提出基于强化学习的协作框架,解决LMM在计数与定位上的视觉短板 |
|
|
论文标题:Patching the visual ability of large multimodal models by collaborating with small models
期刊:Frontiers of Computer Science
作者:Hao LIANG, Xiaolong ZHANG, Meina KAN, Shiguang SHAN, Xilin CHEN
发表时间:21 May 2025
DOI:10.1007/s11704-025-41126-5
微信链接:点击此处阅读微信文章
标题:Patching the visual ability of large multimodal models by collaborating with small models
作者:Hao LIANG, Xiaolong ZHANG, Meina KAN, Shiguang SHAN, Xilin CHEN
DOI:10.1007/s11704-025-41126-5
扫码阅读原文↑
摘要:
尽管多模态大模型(LMM)在推理与规划上表现卓越,但在物体计数、精确定位等基础视觉任务中仍存在明显缺陷。中国科学院计算所阚美娜等提出了一种创新的“打补丁”方法:通过引入任务专用的小模型与LMM协同工作,并设计了一种基于强化学习的模型选择器,根据任务需求动态调度模型。实验证明,该方法在无需微调大模型的前提下,显著增强了LMM的视觉感知精度,为构建更可靠的通用人工智能提供了新思路。
内容精要
多模态大模型(LMM)作为通向通用人工智能的重要路径,在视觉问答、辅助编程等领域已展现出惊人潜力。然而,一个长期困扰学术界的技术痛点是,LMM的“视觉”并不像其“大脑”一样精准。在处理诸如“图中具体有多少个物体”或“特定目标的精确像素位置”等基础视觉功能时,LMM常会出现严重的感知幻觉或识别偏差。由于这些模型通常拥有数十亿甚至上千亿的参数,单纯依靠增加训练数据或全量微调来修复这些零散的视觉缺陷,不仅计算成本极其昂贵,且极易陷入“修好一个漏洞又出现新漏洞”的低效循环。
为了攻克这一难题,中国科学院计算所阚美娜等提出了一种名为“视觉补丁(Visual Patching)”的协作框架。该框架的核心思想是将LMM从繁重的视觉底层感知任务中部分解脱出来,转而发挥其强大的逻辑调度能力。系统首先利用LMM将复杂的查询分解为一系列基础视觉函数。针对每一个函数,系统并不是盲目地信任LMM,而是通过一个专门设计的“模型选择器”来决定:是使用LMM自带的视觉模块,还是调用一个领域专用且精度更高的“小模型”(如专门的计数器、OCR识别器或定位模型)作为补丁。
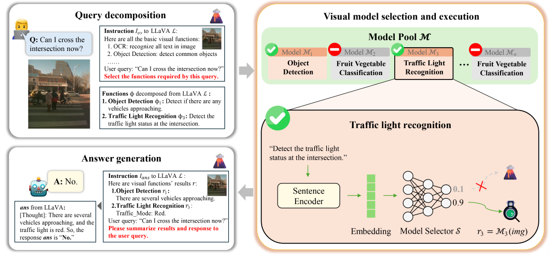
这一协作过程的精髓在于其引入的基于问答反馈的强化学习策略。该策略能自动学习并评估大模型与不同小模型在特定任务上的表现优劣,从而优化选择器的决策逻辑。最终,LMM会汇总所有视觉函数的执行结果,并结合其语言建模能力生成最终答案。多项对比实验表明,该方法在标准视觉问答数据集及专业细分场景下均取得了显著的性能提升。这种“大模型管逻辑、小模型管感知”的范式,不仅极大提高了模型修复的效率,也保留了大模型原有的泛化能力,为分布式、模块化的AI系统构建提供了重要参考。
期刊简介
Frontiers of Computer Science (FCS)是由教育部主管、高等教育出版社和北京航空航天大学共同主办,南京大学支持,SpringerNature 公司海外发行的英文学术期刊。本刊于 2007 年创刊,月刊,全球发行。主要刊登计算机科学领域具有创新性的综述论文、研究论文等。本刊主编为周志华院士,执行主编为周昆教授。编委会及青年 AE 团队由国内外知名学者及优秀青年学者组成。本刊被 SCI、Ei、DBLP、INSPEC、SCOPUS 和中国科学引文数据库(CSCD)核心库等收录,为 CCF 推荐B类期刊;两次入选“中国科技期刊国际影响力提升计划”;入选“第4届中国国际化精品科技期刊”;两次入选“中国科技期刊卓越行动计划”(一期梯队、二期领军)。
特别声明:本文转载仅仅是出于传播信息的需要,并不意味着代表本网站观点或证实其内容的真实性;如其他媒体、网站或个人从本网站转载使用,须保留本网站注明的“来源”,并自负版权等法律责任;作者如果不希望被转载或者联系转载稿费等事宜,请与我们接洽。