|
|
|
|
|
FCS 苏州大学团队提出统一解析框架,有效解决多模态并行语料稀缺难题 |
|
|
论文标题:Bridging modalities: a unified framework for textual and multimodal dialogue discourse parsing
期刊:Frontiers of Computer Science
作者:Chen GONG, Nan YU, Guo-Hong FU
发表时间:24 Jun 2025
DOI:10.1007/s11704-025-50170-0
微信链接:点击此处阅读微信文章
标题:Bridging modalities: a unified framework for textual and multimodal dialogue discourse parsing
作者:Chen GONG , Nan YU, Guo-Hong FU
DOI:10.1007/s11704-025-50170-0
扫码阅读原文↑
摘要:
针对文本与多模态对话话语分析任务长期分离的现状,苏州大学研究团队提出了一种统一的分析框架。该框架首先在纯文本语料上进行预训练,随后通过跨模态对比学习策略扩展至多模态场景。这种方法不仅克服了多模态标注数据稀缺的瓶颈,还实现了不同模态间知识的深度融合与迁移。实验结果显示,该统一框架在文本和多模态基准测试上均表现优异,显著提升了对话结构理解的泛化性。
内容精要
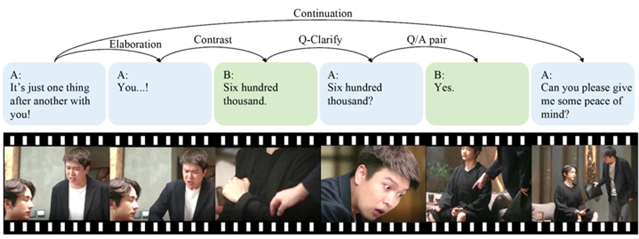
对话话语分析是自然语言理解的核心任务,旨在揭示对话中各发言序列间的逻辑关联。然而,现有研究面临一个严峻的技术痛点:由于缺乏大规模、高质量的多模态并行标注数据集,研究者通常不得不针对纯文本和多模态对话分别设计两套独立的解析器。这种任务孤立的现状不仅导致模型无法充分利用跨模态的互补信息,还增加了在实际应用中的部署复杂性。如何构建一个既能兼容纯文本又能理解多模态交互的统一解析模型,同时克服多模态标注数据极度匮乏的挑战,已成为当前多模态人工智能领域亟待突破的关键难题。
针对这一挑战,苏州大学团队提出了一种创新的统一对话话语分析框架。该研究的核心思路是“由简入繁、知识迁移”。研究人员首先利用海量的纯文本对话数据预训练一个基础解析器,使其掌握核心的语义关联建模能力。随后框架引入了专门的多模态编码器与融合模块,在保持预训练文本参数冻结的情况下,通过跨模态对比学习策略,将视觉等辅助信息与文本表征进行对齐。这种设计不仅提升了模型在模态缺失情况下的鲁棒性,还成功将在纯文本领域积累的知识有效迁移至多模态场景中。
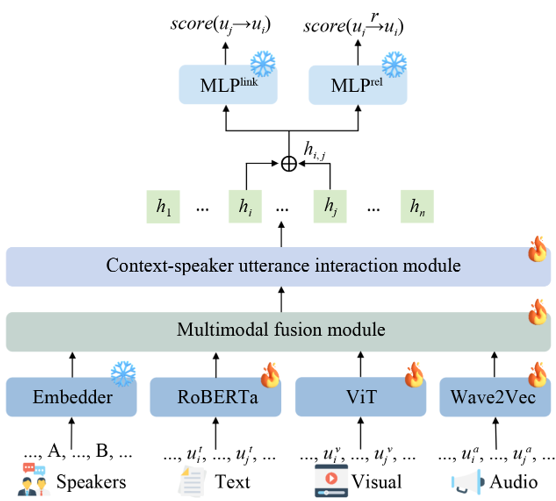
实验结果表明,该统一框架在文本数据集STAC和多模态数据集MMC上均取得了突破性进展。相比于传统的单模态模型,该方法不仅在解析准确度上实现了飞跃,更在跨模态推理中展现了极强的灵活性。研究通过多模态融合有效地消解了对话中的语义歧义,为长篇、复杂对话的结构化理解提供了有力支撑。该成果填补了多模态对话分析统一建模的空白,也为未来开发通用型对话智能体奠定了坚实的技术基础。
期刊简介
Frontiers of Computer Science (FCS)是由教育部主管、高等教育出版社和北京航空航天大学共同主办,南京大学支持,SpringerNature 公司海外发行的英文学术期刊。本刊于 2007 年创刊,月刊,全球发行。主要刊登计算机科学领域具有创新性的综述论文、研究论文等。本刊主编为周志华院士,执行主编为周昆教授。编委会及青年 AE 团队由国内外知名学者及优秀青年学者组成。本刊被 SCI、Ei、DBLP、INSPEC、SCOPUS 和中国科学引文数据库(CSCD)核心库等收录,为 CCF 推荐B类期刊;两次入选“中国科技期刊国际影响力提升计划”;入选“第4届中国国际化精品科技期刊”;两次入选“中国科技期刊卓越行动计划”(一期梯队、二期领军)。
特别声明:本文转载仅仅是出于传播信息的需要,并不意味着代表本网站观点或证实其内容的真实性;如其他媒体、网站或个人从本网站转载使用,须保留本网站注明的“来源”,并自负版权等法律责任;作者如果不希望被转载或者联系转载稿费等事宜,请与我们接洽。