|
|
|
|
|
机器学习融合COSMO-SAC精准高效预测二元混合物的无限稀释活度系数 |
|
|
研究背景
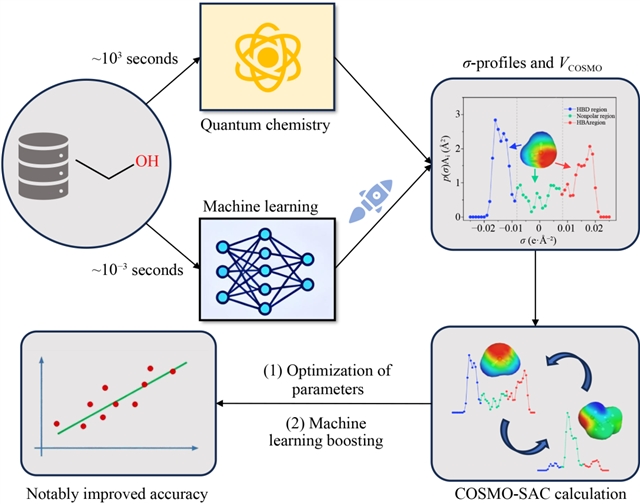
在化工过程的溶剂设计与筛选中,无限稀释活度系数(γ∞)是表征液体混合物相平衡、指导溶剂理性选择的核心热力学参数,是溶剂筛选的“关键标尺”,其预测精度与效率直接决定了溶剂研发的进度、成本与实用性。传统γ∞预测方法要么依赖耗时耗力的实验测定,或者受限于模型本身的精度缺陷或计算效率瓶颈,难以满足大规模高通量溶剂筛选的工程需求。近期华东理工大学宋震教授团队联合哥伦比亚大学陈顾中博士后发表的研究论文,将机器学习(ML)与经典热力学模型COSMO-SAC深度融合,构建出兼具高精度、高速度与物理可解释性的γ∞预测混合模型,突破了传统方法的多重桎梏,为化工领域的溶剂高通量筛选提供了全新的高效解决方案。
论文摘要
无限稀释活度系数(γ∞)是化学过程溶剂设计中的一个关键热力学参数。尽管分段活度系数的导体样筛选模型(COSMO-SAC)表现出很强的先验预测能力,但其估计有时只是定性的,而不是定量的。COSMO-SAC的另一个局限性源于对时间密集型量子化学计算的依赖,这限制了其在大规模溶剂筛选中的可扩展性。为了克服这些问题,本研究将COSMO-SAC与ML相结合,对二元混合物进行精确的预测。通过绕过量子化学计算的必要性,多任务机器学习模型可以快速预测分子和离子的表面电荷密度分布(σ-profiles)和分子腔体积(VCOSMO),同时准确区分异构体。利用20000多个实验数据点对COSMO-SAC的四个可调参数进行了优化,并采用增强集成策略进一步校正了残余系统误差,以提高模型性能。由此产生的混合模型将平均绝对误差从0.944降低到0.102(R2=0.969),提高了89%,同时保持了模型的物理化学可解释性。这种准确有效的方法拓宽了σ-profiles和VCOSMO预测的实际适用性,基于COSMO-SAC计算,促进了各种化学工程应用的高通量溶剂筛选。
研究亮点
多任务ML模型实现关键参数快速精准预测,突破量子化学计算桎梏
双阶段模型优化,实现从定性预测到定量精准的跨越
兼顾物理可解释性与工程实用性,适配化工高通量筛选需求
全面验证模型性能,攻克氢键体系预测误差大的行业痛点
研究结论
本研究成功构建了融合机器学习与COSMO-SAC的混合模型,实现了二元混合物无限稀释活度系数(γ∞)的快速、精准、可解释预测。研究开发的多任务Transformer-CNN模型,绕开了耗时的量子化学计算,可快速精准预测σ-profiles和VCOSMO,且能有效区分异构体、离子液体等,参数预测精度达到行业领先水平。基于超2万组实验数据的评估显示,原始COSMO-SAC模型的预测存在显著局限性,仅能实现定性预测,且在氢键混合体系中误差较大。通过对COSMO-SAC四个核心参数的优化,模型预测性能得到初步提升;再结合boosting集成学习策略进行残差校正,最终混合模型的平均绝对误差从0.944降至0.102,精度提升89%,R2达0.969,远超传统模型,实现了从定性预测到定量精准的跨越。该混合模型既保留了COSMO-SAC的物理化学可解释性,又具备机器学习的高效性与高精度,突破了传统溶剂筛选方法在效率、精度、功能上的多重瓶颈,为计算机辅助分子设计与溶剂高通量筛选提供了强大工具,拓宽了COSMO-SAC模型在化工领域的实际应用场景。
详细解读
多任务ML模型精准预测,突破量子化学计算桎梏
研究搭建Transformer-CNN多任务深度学习模型,基于COSMObase 2022数据库完成训练,可直接从分子结构出发,同步预测σ-profiles(51个片段)和VCOSMO,无需进行耗时的量子化学计算。该模型处理12000余个分子/离子仅需12.8 s,相较传统量子化学计算(小分子需数十分钟,大分子耗时数小时),效率实现大幅提升。同时模型解决了传统基团贡献方法的核心缺陷,可精准区分对映异构体、顺反异构体,还能识别质子化/去质子化分子及离子液体,参数预测精度极高(σ-profiles预测R2=0.982,VCOSMO预测R2=0.997),能完美替代量子化学计算的结果。
双阶段模型优化,实现从定性预测到定量精准的跨越
针对原始COSMO-SAC模型γ∞预测精度低的问题,研究采用“参数优化+残差校正”双阶段优化策略。首先基于21284个涵盖302种溶质、447种溶剂的实验数据,通过贝叶斯优化算法对COSMO-SAC的4个核心可调参数(有效表面段面积、氢键常数、氢键sigma截止值、失配能常数)进行全局优化,使模型平均绝对误差降至0.510,R2 提升至0.625,实现了预测性能的初步飞跃。在此基础上,引入boosting集成学习策略,用ML模型学习实验值与优化后COSMO-SAC预测值的残差并进行校正,进一步消除系统误差,最终让模型预测精度实现质的提升,完成从“定性预测”到“定量精准”的关键转变。
兼顾可解释性与实用性,适配化工高通量筛选需求
与纯机器学习模型的“黑箱”特性不同,本研究构建的COSMO-SAC-ML混合模型保留了COSMO-SAC的热力学物理意义,模型的每一步计算均有明确的物理化学内涵,更符合化工工程的实际应用要求。同时模型突破了传统方法在效率、精度、异构体识别上的多重限制,可快速处理海量分子/离子体系,为化工过程中气体吸收、萃取、反应等场景的溶剂高通量筛选提供了可靠工具,兼具理论价值与工程实践价值。
全面验证模型性能,攻克氢键体系预测误差行业痛点
研究基于超2万组实验数据,对原始COSMO-SAC模型的预测性能进行了系统全面的评估,发现其在氢键混合体系(如卤代物-醇类)中存在显著的预测误差,而在非氢键体系中表现相对较好。针对这一行业痛点,优化后的混合模型在氢键与非氢键混合体系中均实现了高精度预测,案例验证显示模型预测值与实验值高度吻合,彻底解决了原始COSMO-SAC模型在氢键体系中误差大的问题,模型的通用性与可靠性得到充分验证。
亮图解读
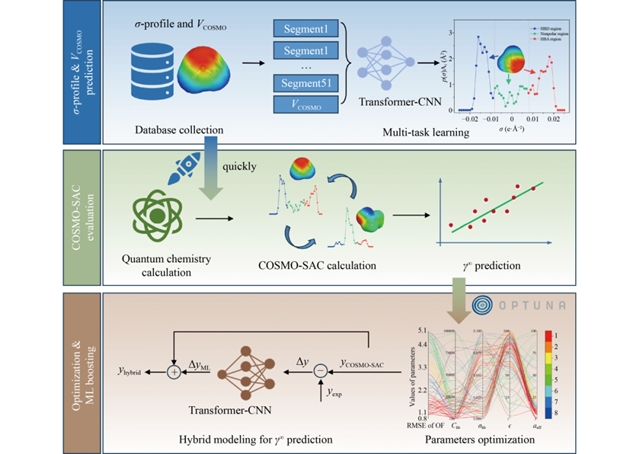
图1.COSMO-SAC-ML混合模型的构建与应用全流程:整个流程形成“快速参数预测-模型性能评估-精准优化校正”的闭环,逻辑连贯、步骤明确,直观体现了研究“ML赋能经典热力学模型”的核心设计思路。
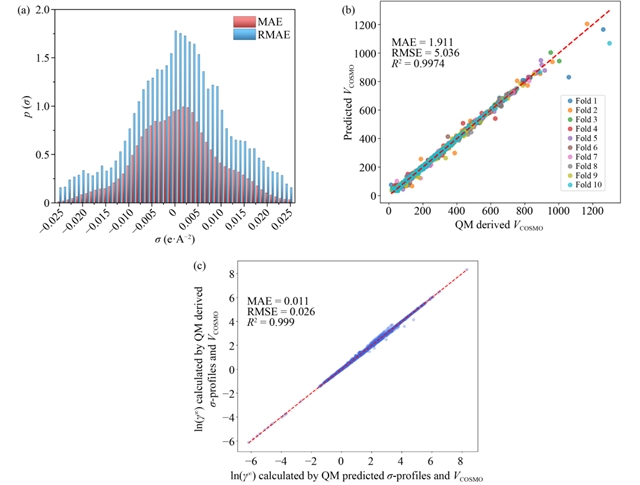
图2.ML模型对σ-profiles和VCOSMO的预测性能:从3个维度验证了多任务ML模型的预测精度:其一,σ-profiles的51个片段预测误差均可控,即使是误差相对较大的非极性区域,平均绝对误差仍低于1;其二,VCOSMO的预测数据点紧密聚集在对角线附近,证明模型对分子腔体积的预测与量子化学计算结果高度一致;其三,利用ML预测参数与量子化学计算参数分别进行COSMO-SAC的γ∞计算,结果几乎完全重合(R2=0.999),直接证实ML预测可精准替代量子化学计算,为后续模型构建奠定了坚实基础。
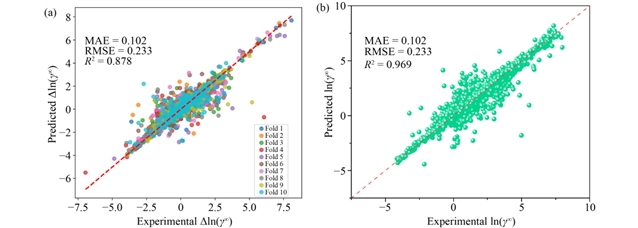
图3.混合模型的最终γ∞预测性能:该图是研究核心成果的直观体现,其中子图(a)验证了ML模型对残差的预测精度,子图(b)展示了经残差校正后混合模型的最终性能。混合模型的预测数据点几乎完美分布在理想对角线附近,平均绝对误差仅0.102,R2高达0.969,与原始COSMO-SAC模型形成鲜明对比,清晰展现了模型经优化校正后的精度飞跃。(来源:EngineeringJournals微信公众号)
相关论文信息:
https://journal.hep.com.cn/fcse/EN/10.1007/s11705-026-2625-y
特别声明:本文转载仅仅是出于传播信息的需要,并不意味着代表本网站观点或证实其内容的真实性;如其他媒体、网站或个人从本网站转载使用,须保留本网站注明的“来源”,并自负版权等法律责任;作者如果不希望被转载或者联系转载稿费等事宜,请与我们接洽。